AI 回应品质评估(AI Evaluation)

评估 AI 回应的准确性、相关性与一致性,追踪模型、Prompt 或系统变更对结果的影响,作为上线与改善依据。

AI Evaluation & Quality Challenges

您如何判断 AI 回应,
是否足够可靠?

当同一问题出现不同答案,或模型更新后结果产生变化,
回应品质将变得难以预测,也难以验证。

难以量化回应品质与准确度
难以追踪模型变更带来的影响

AI 品质评估与治理能力

从测试集、Ground Truth 到评分规则与人工覆核,建立可重复的 AI 回应品质评估流程。

LogsRuntime
Response Logging

收集必要推论资料

按资料政策收集 AI 系统的必要输入、输出与上下文,为评估提供资料基础。

  • 追踪必要 Prompt 与回应内容
  • 支援 Chatbot 与 Agent 工作流
  • 基于真实或测试资料进行分析
Pipeline
Evaluation Pipeline

可重复评估流程

建立标准化流程,对大量 AI 回应进行批量评估、比较与追踪。

  • 支援批量评估与定时执行
  • 可自订评分逻辑与规则
  • 适用不同应用场景与模型
Evaluation
Ground Truth

Ground Truth 与测试集管理

建立标准答案与测试资料,让评估结果具备一致的比较基准。

  • 测试集与版本管理
  • 支援人工标注与修正
  • 建立可重复验证的评估基准
Scoring
Scoring

多维度评分机制

针对不同指标对 AI 回应进行量化评分,协助分析模型与 Prompt 表现。

  • 准确性与语意相关性评估
  • 幻觉与偏差检测
  • 产出可比较的评分结果
Dashboard
Dashboard

品质监控与分析看板

透过视觉化数据,追踪模型表现、版本变化与异常案例。

  • 分数与趋势变化视觉化
  • 模型版本前后比较
  • 异常案例分析与追踪
Deployment
Deployment

私有化部署与数据安全

可按企业要求选择部署与资料处理方式,控制评估资料的存取与保存。

  • 支援私有云与本地部署选项
  • 可配置评估资料处理方式
  • 配合企业资安与审计需求
AI Response Evaluation Chart
Quality Governance

将 AI 回应品质转化为可量化指标

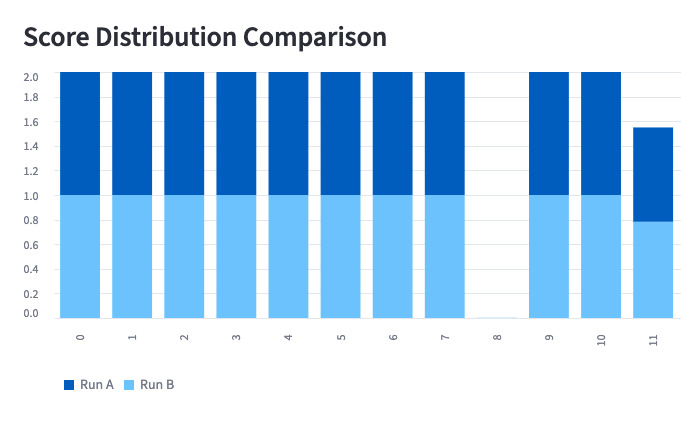
透过标准答案(Ground Truth)与批量评估机制,将 AI 回应转化为可比较、可追踪的数据,协助团队持续优化模型表现。
  • 建立评估基准: 定义标准答案与测试案例,支援一致的比较方式
  • 自动比对回应: 将 AI 回应与基准答案进行比对,识别错误与偏差
  • 多维度评分: 针对准确性、相关性与合规性进行批量评估
AI Performance Dashboard and Deployment Control
Decision & Control

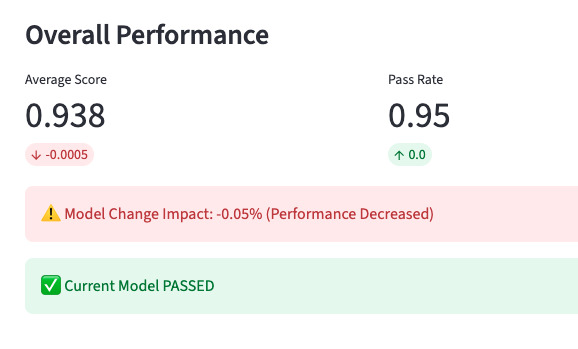
用评估结果辅助上线判断

透过评估结果设定参考门槛,协助团队判断模型、Prompt 或系统变更是否需要调整、覆核或暂缓上线。

  • 设定上线门槛: 根据评分结果辅助判断部署、调整或暂停
  • 追踪变更影响: 比较模型更新前后表现,识别回应品质变化
  • 人工审核机制: 在关键流程加入人工检视,覆核重要场景品质

应用场景

支援 AI 系统的开发、测试与部署,协助团队建立上线判断与改善依据

Conversational AI

客服回应品质评估

分析 Chatbot 回应是否准确、相关和一致,协助判断是否符合企业服务标准。

  • 评估回应准确性与语意一致性
  • 识别错误与异常回覆
  • 建立可量化的服务品质指标
AI Agent & Workflows

Agent 与流程执行评估

分析多步骤 AI 流程中的每个环节,找出错误与效能问题。

  • 评估多步骤推论结果
  • 定位流程中的错误节点
  • 分析自动化任务执行品质
Model Iteration

模型版本比较与验证

比较不同模型或设定的输出结果,作为是否适合上线的判断依据。

  • 新旧模型输出结果比较
  • 分析回应品质差异
  • 评估模型更新带来的影响
CI/CD for AI

Prompt 与系统变更验证

在 Prompt 或系统逻辑变更后,验证对输出结果的影响。

  • 变更前后结果比较
  • 分析 Prompt 调整影响
  • 部署前品质检查

导入流程

从资料收集、测试集到评分与覆核,建立可重复运行的 AI 品质评估流程

01

收集 AI 推论数据

按资料政策记录 AI 系统必要的输入、输出与上下文,作为评估的基础资料。

02

比对标准答案

将回应与 Ground Truth 或测试集进行比对,分析差异与偏差。

03

进行多维度评估

从准确性、相关性、一致性等指标进行评分,量化 AI 回应品质。

04

分析结果并优化

透过仪表板检视结果,支援模型调整、Prompt 优化、人工覆核与部署判断。

常见问题

了解 AI 评估如何协助团队建立品质比较、人工覆核与上线判断依据

评估数据从哪里来?是否反映真实情况?
评估可基于 AI 系统实际运行的推论数据(Logs),也可使用测试集或人工标注资料。实际采用方式会按场景、风险与资料政策配置。
评估过程中,数据会外流吗?
不一定。可按企业要求选择本地、私有云或其他受控部署方式,并设定评估资料的存取、保存与传输规则。
如何量化 AI 回应品质?
透过多维度评分机制,从准确性、语意相关性与合规性等指标进行分析,将回应品质转化为可比较的数据。
如何建立 Ground Truth(标准答案)?
可汇入既有知识库、测试案例或由团队进行标注,并透过版本管理持续更新,让评估基准保持一致且可追踪。
是否支援大量数据的批量评估?
支援批量分析与定时评估,可用于模型回测、Prompt 变更比较与日常品质监控。高风险结果仍建议加入人工覆核。
评估结果如何帮助决策?
透过仪表板检视评分、趋势与异常案例,并比较不同版本表现,作为部署、调整或人工覆核的参考依据。
评估结果可以取代人工审核吗?
不建议完全取代。评估结果适合作为筛选、比较与追踪依据;在高风险、合规、金融、医疗或客户承诺场景中,仍应保留人工覆核。

从一组 AI 评估案例开始

先建立测试集、评分规则与人工覆核流程,再逐步形成可重复的 AI 品质评估体系。